Идея проекта
Как далеко можно изменить контекст, сохранив персонажа?
Проект исследует, насколько генеративная модель способна сохранить индивидуальные особенности реального персонажа при переносе его в ситуации, отсутствовавшие в обучающем датасете.
Один персонаж — множество новых ролей
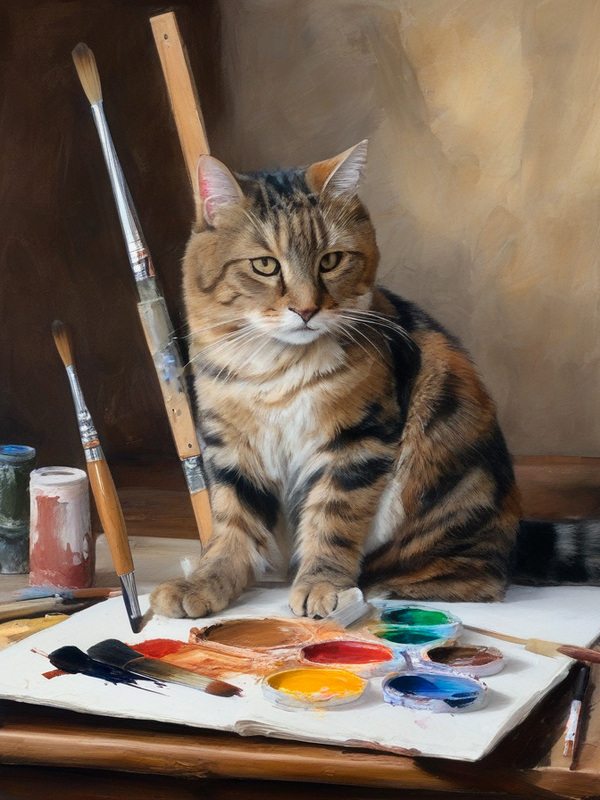
В основе проекта — мой кот Чарли и серия его фотографий. Я обучила персональную LoRA-модель на базе Stable Diffusion XL, чтобы проверить, сможет ли нейросеть не просто генерировать похожего кота, а удерживать идентичность конкретного персонажа в новых ситуациях.Для итоговой серии я поместила Чарли в разные профессиональные роли: писателя, художника, библиотекаря, механика, офисного работника, пианиста и повара.Для меня было важно не просто получить смешную серию «кот в профессиях», а исследовать границу между сохранением идентичности и генеративной интерпретацией: какие особенности Чарли модель считает определяющими и в какой момент новая сцена начинает вытеснять исходный образ.
Исходный датасет
Как модель узнавала Чарли
Для обучения использовались только собственные фотографии Чарли. В итоговый датасет вошло 76 изображений.
При отборе я старалась показать персонажа с разных сторон: крупные портреты, профиль и ¾, разные положения тела, разные дистанции до камеры и условия освещения. При этом я исключала почти одинаковые дубли и фотографии, на которых плохо читаются морда или рисунок шерсти.
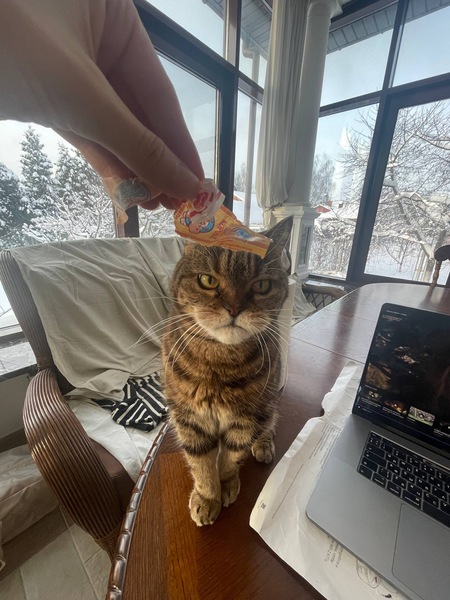
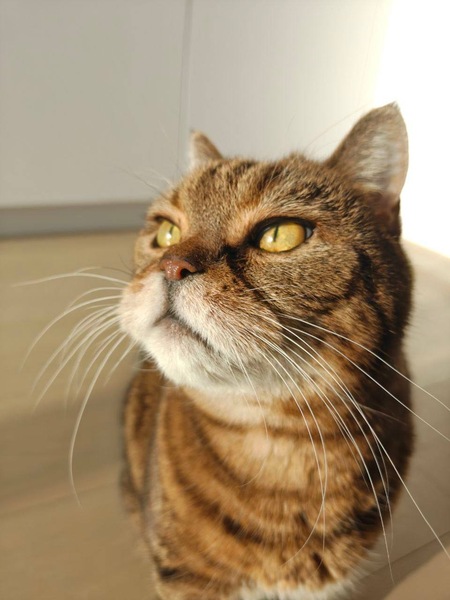
Фотографии Чарлюши
Перед обучением изображения были приведены к единому квадратному формату 512×512. Исходный кадр сохранялся целиком: вместо обрезки использовались поля вокруг изображения. Такой способ позволил не терять части тела и характерные признаки персонажа при подготовке обучающих данных.
Как выглядели изображения с полями
Подготовка изображений
Подготовка датасета к обучению
Для обучения SDXL изображения были приведены к единому формату 512×512.
Я решила не обрезать исходные фотографии до квадрата, поскольку при crop могли теряться части тела и характерные особенности персонажа. Вместо этого изображение целиком помещалось на квадратный canvas, после чего уменьшалось до 512×512.
Как модель связывает изображения с Чарли
Trigger token
Для персонажа был задан уникальный trigger token chrlcat.
Во время обучения использовался prompt a photo of chrlcat cat. Таким образом, модель должна была связать слово chrlcat не с текстовым описанием окраса или породы, а с визуальными признаками конкретного персонажа.
Обучение модели
DreamBooth + LoRA
Основой проекта стала Stable Diffusion XL 1.0. Для персонализации модели использовались DreamBooth и LoRA.
Обучение проходило в разрешении 512×512 в течение 600 шагов. Промежуточные checkpoints сохранялись каждые 100 шагов, чтобы можно было сравнивать степень усвоения персонажа.
В итоговой конфигурации также использовались gradient checkpointing, fp16, 8-bit Adam и snr_gamma=5.0. Эти параметры позволяли провести обучение SDXL в ограниченной GPU-памяти Google Colab.
От обучения к генерации
Выбор обученной версии
После обучения я тестировала промежуточные checkpoints и силу влияния LoRA.
Для итоговой серии использовалась выбранная версия модели с фиксированным LoRA scale. Это позволило сохранить влияние обученного персонажа, одновременно оставив базовой SDXL возможность создавать новые окружения и действия.
Итоговая серия
Чарли в разных профессиях
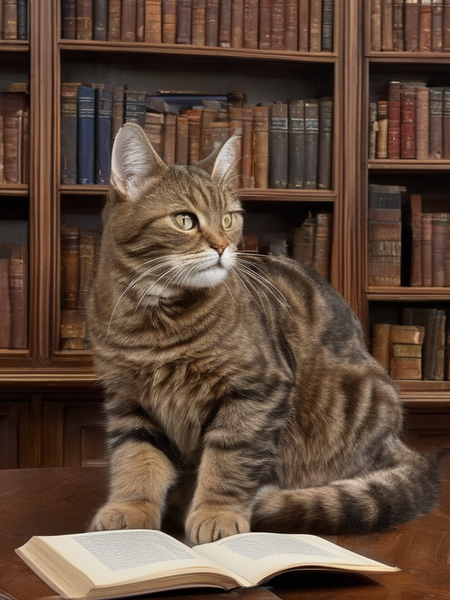
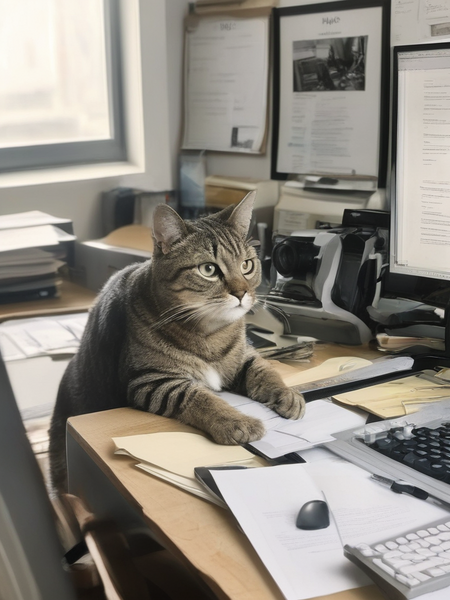
Слева-напрово: Чарльз как библиотекарь // Чарльз как офисный сотрудник